Context 随记,对 Context 和 Agent 的思考
Context 随记,对 Context 和 Agent 的思考
本文并不推荐 skills,也不推荐工作流
本文由 okJiang 和 GPT6-Pro(深度研究),Kimi-K3(画图、润色)合作完成
从 Matt 的 Skill 说起
初遇 grill-me
grill-me 这个 skill 在几个月前一度爆火。我近几个月一直在深度使用其作者 Matt Pocock 的一系列 skills,主要是
/grill-with-docs/wayfinder(后续加入)/to-spec/to-tickets/implement/writing-for-agents。。。
我在使用期间的感受是,它真正做到了作者提到的 AFK(Away From Keyboard),在你把前序步骤完成之后,键盘敲入 /implement,真的可以双手离开键盘,它可以完成这个任务!按照我们的约定完成!
在 /grill-me 爆火的那段时间,我看到非常多的人在试用中被折磨,“我被拷打了一百多个问题!”。没错,我也是😭。当时的想法就是,怎么还不结束啊!认真的阅读每一个问题的话,可能一天都回答不完。。。
它真的能提高我们的效率吗?
珍贵的 Context window
在多次跑完 /grill-with-docs -> /to-spec -> /to-tickets -> /implement 的流程之后,我逐渐意识到,它在对抗什么,LLM 最有限的资源 —— context window
现在已经长期使用 coding agent 的我们都知道了,下面这些问题频繁地在使用过程中骚扰我们:
上下文污染
上下文腐化
上下文漂移
而 Matt 这一套流程则强调:
使用一个 session 来执行
/grill-with-docs->/to-spec->/to-tickets分别用不同的 session 来
/implement各个 ticket
简单介绍:
/grill-xx 会把你提出的问题以 design tree 的形式进行穷举,以让你的这个想法足够地缜密
/to-spec 则会把 grill 中讨论的结论总结为 spec 的形式
/to-tickets 则会进一步把 spec 拆分成可以执行的票据
/implement 让 agent 根据 ticket 和 spec 进行实现和 review
强烈建议去仔细阅读一遍原始的 SKILL
Matt 经常提到的一个概念是 Smart Zone,通常指:
一个会话中,上下文还比较短、干净、相关度高时,模型表现最稳定、推理最敏锐的那一段上下文范围。
他的 AI coding dictionary 把它描述为:会话早期 Agent 比较专注、记忆和指令遵循较好;随着 context 越来越长,会逐渐进入所谓 “Dumb Zone”,出现遗忘、重复犯错、前后矛盾等问题。
1 | 上下文使用量 |
这个流程就充分应用了 smart zone,并且刻意地在避免上面提到的各种上下文问题,比如步骤 2 就刻意避开了长段的 grill 文本,而是在新 session 中去实现代码,因为 implement agent 它没有必要去了解那么多的原始问答,那对于 context window 是一种浪费
新鲜的 Context,Agent 的最爱
/domain-modeling 是 /grill-with-docs 的底层技能,它规定了在 grilling 的过程中,如果涉及到了一些概念/领域术语,它会尝试把它的定义确定下来,记录在 CONTEXT.md 中;假设涉及到了一些关键决策,则会被记录到 ADR.md(架构决策记录) 中。
ADR 是架构决策记录。skill 规定,只有一个决定同时满足下面三点,才应该提议创建 ADR:
难以逆转——以后改主意有明显成本
缺少背景就令人费解——后来的人会问“为什么要这样做”
确实做过取舍——存在真实可行的替代方案,最终有理由地选了其中一个
/grill-with-docs和/grill-me最大的区别就是是否启动/domain-modeling
1 | / |
而在使用 Matt 的 grill 技能之前,必须要做的前置操作是 /setup-matt-pocock-skills。它会编写 AGENTS.md,告诉 Agent:
如何使用和找到 CONTEXT.md 和 ADR.md
在哪里去创建 /to-spec 和 /to-tickets 的产物,linear 还是 github
这些设置会让你的领域术语、关键决策时刻存放在 repo 中,并且 Agent 在处理问题时永远有办法可以找到它们。这非常有利于规范 Agent 的行为,以防止 Agent 创造出新的术语让仓库变的一团糟,或者它们自行进行违背决策的操作导致偏离。
One session One problem
上面提到的一系列 skills 其实已经可以完成日常工作的闭环了。但对于较大的任务,grilling 实在是太痛苦了,比如最开始提到的,一次完整的 /grill-me 整整拷打了一百多个问题!这甚至可能会触发多次 context compact 以致于丢失上下文。为了应对这种大型问题,Matt 创建了 /wayfinder skill。
使用 /wayfinder 可以直接开始一个还没有想清楚的大任务,它会首先产出一张 map。Map 本身是一系列模糊事项的索引,而不展示所有细节;每个 decision ticket 才保存具体问题与 resolution。一个 session 首先读取 map,需要时再去看某张 ticket 的细节。默认一次 session 只解决一个 decision ticket,research tickets 则可以交给 Agent 并行处理。
1 | /wayfinder |
这和“开一个很长的聊天,把整个项目一直做完”的思路不太一样。
一个 session 结束以后,留下的是已经解决的问题,以及由这个答案暴露出来的新问题。下一个 session 重新读取 map,知道现在走到了哪里,再选择一个可以处理的问题继续。它不需要记得上一次聊天的全过程。
一张 closed GitHub Issue 则保存了当前工作的处境:我们试图到哪里,已经决定了什么,还有哪些问题没有答案。依赖关系又告诉后面的 agent,下一步现在到底可以做什么。
从这个角度,我开始思考:一个能持续工作的 agent workflow,不应该依赖某个 agent 一直记住所有事情,而应该让一个失忆的新 agent,也能迅速恢复对当前工作的正确理解。
Context 到底是什么?
Context 是怎样从讨论里发芽的
一个需求刚开始的时候,很多 context 还没有存在于任何文字中。
它只存在于产品 owner 的判断、偏好、边界感和未言明的假设里面。甚至有些东西,自己也还没有想清楚。
/grill-with-docs 组合了 grilling 和 domain-modeling。Grilling 的核心不是“问很多问题”,而是建立一棵 design tree:只有前置条件已经确定的节点,才进入当前可以讨论的 frontier。用户回答以后,tree 被重新计算,新的问题才出现。Agent 要自己寻找事实,不能把可以查到的问题甩给用户;真正需要取舍的 decisions,才交给用户决定。
这把人脑里隐含的 context 逐渐 externalize。
而 domain-modeling 会在概念刚刚确定时,把它写入 CONTEXT.md。真正不可轻易逆转、没有 context 会令人意外,并且确实经历过 trade-off 的决策,才进入 ADR。
当然,不是所有问题都能靠讨论得到答案。
有些问题需要
/research。Research 保存的是 evidence:文档怎么说,外部系统实际上怎样工作,有什么限制。/research后的 Decision 保存的则是面对这些事实,我们决定怎么做。另一些问题,用文字讨论的成本太高,需要
/prototype。一个代码原型可以是为了回答某个问题而写的 throwaway code(随意丢弃的代码)。验证之后,经过确认的决策进入正式实现;prototype 留在对应的 branch,作为可以回头查看的 primary source,再由 issue 留下 pointer。
所以 context 不一定是文字。一个可以运行的 HTML、一段 state machine,可能比一篇文档更有效。
spec、research、prototype、ADR,并不是一堆互相重复的“文档”。它们承担着不同类型的 context,也有不同的生命周期。
Context 的降维
问题逐渐讨论清楚以后,我们很难一次性把这么多上下文塞到一个 session 里。还要把这些 context 整理成适合 /implement 的形式。
/to-spec把大段 discussion、code exploration、已经作出的 decisions,以及 domain constraints,压缩成实现所需的较短的表述。之前为什么讨论了那么久、查过哪些文件、绕过哪些弯路,不一定都需要出现在 implementation agent 的当前 context 里。/to-tickets再把 spec 转成适合 agent 在一个 fresh context window 就能完成的 vertical slices tickets,并显式记录 blocking edges。
垂直切片(vertical slicing)按“一个小而完整、可以验收的功能行为”拆,而不是按“数据库、后端、前端”等技术层拆
所以 ticket 不只是为项目管理服务的。它也可以被理解成一个 context envelope(上下文信封):给一次相对独立的工作划定范围,让一个新 session 知道自己要完成什么、依赖什么。
HumanLayer 的 Dex Horthy 从另一个方向描述过类似的做法。他们采用
Research → Plan → Implement的流程,有意识地把搜索、读代码和工具输出等高体积过程,整理成 structured artifacts,让 implementation 从一个较干净的 context window 开始。他把这个过程叫作 intentional compaction。(HumanLayer)
Context pointer
在前面的章节有提到,Agent 可以很方便地查阅 CONTEXT.md 和 ADR 的内容。那么每个新的 agent 是怎么知道它们存在?又怎么知道什么时候应该读?
Matt 在 /writing-for-agents 里提供了一个很具体的概念:context pointer。
它是在当前 context 中的一小段引用,指向 context window 外面的材料,同时说明“在什么条件下应该去读取它”。Pointer 的措辞会影响 agent 何时读取目标材料,以及是否会可靠地读取。一个重要文档后面只有一个含糊的 pointer,仍然可能导致它没有被用上。
一个 ADR 可以暂时不在 window 里,但仍然处于 agent 能够找到的范围内。当前只需要保留足够清楚的入口,等任务走到相关部分时,再读取它。
Matt 对信息的安排也沿着这个思路:当前步骤必须知道的东西直接放在眼前;同一文件中的 reference 按需查阅;只有部分情况才会用到的材料,通过 pointer 逐步展开。放得太多,主要步骤会被淹没;藏得太深,agent 又会错过实际需要的信息。
如何获得这里的最佳实践,需要长时间的实践和测试
这其实就是 skill 的设计理念。我认为 Matt 借鉴了它,然后扩展了它,把它用于所有希望给 Agent 看的文档。
/writing-for-agents之前的名字叫/writing-great-skills
Context 是什么
Context 是一个行动者(Human or Agent)在某一时刻,为了正确理解当前处境并做出下一步行动,能够获得、定位、判断其权威性并使用的全部相关状态。
一张 GitHub Issue 是 context;一个 spec 是 context;一个 prototype branch 是 context;一次失败的实验是 context;一个 ADR 是 context;CONTEXT.md 是 context;tests 是 context;代码本身是 context;目录结构是 context;一个已经关闭的方案同样可能是 context;甚至「这里还有一片我们暂时无法描述清楚的 fog of war」本身,也是在表达 context。
Matt 的体系真正厉害的地方在于,他实际上在设计一套** context lifecycle:让信息从模糊、临时、昂贵的 working context,逐步沉淀成结构化、可寻址、低歧义、可被未来 agent 重建的 durable context。**
总结一下,Context 现在有四个相关的概念
Context window。它回答模型现在看到什么?这个层面的 context engineering 主要讨论 pruning、compression、tool result formatting、retrieval、summarization、prompt composition。
Context field。它的含义是:当前没有加载,但可以被找回的状态。ADR、GitHub issue、prototype branch、research snapshot 都是这样。
Context router。决定什么信息在什么条件下,以什么粒度,以什么权威级别进入 working context。
AGENTS.md、skill descriptions、issue labels、CONTEXT-MAP.md、dependency edges、文件路径约定、tool descriptions,本质上都是这层东西。Context lifecycle。正确的信息从哪里来?它在什么时候从「探索」变成「决定」?什么时候应该长期保存?什么时候反而应该删除?GitHub Issue、research、prototype、spec、ADR、CONTEXT、tests 就是同一份知识在不同成熟度阶段的不同载体。
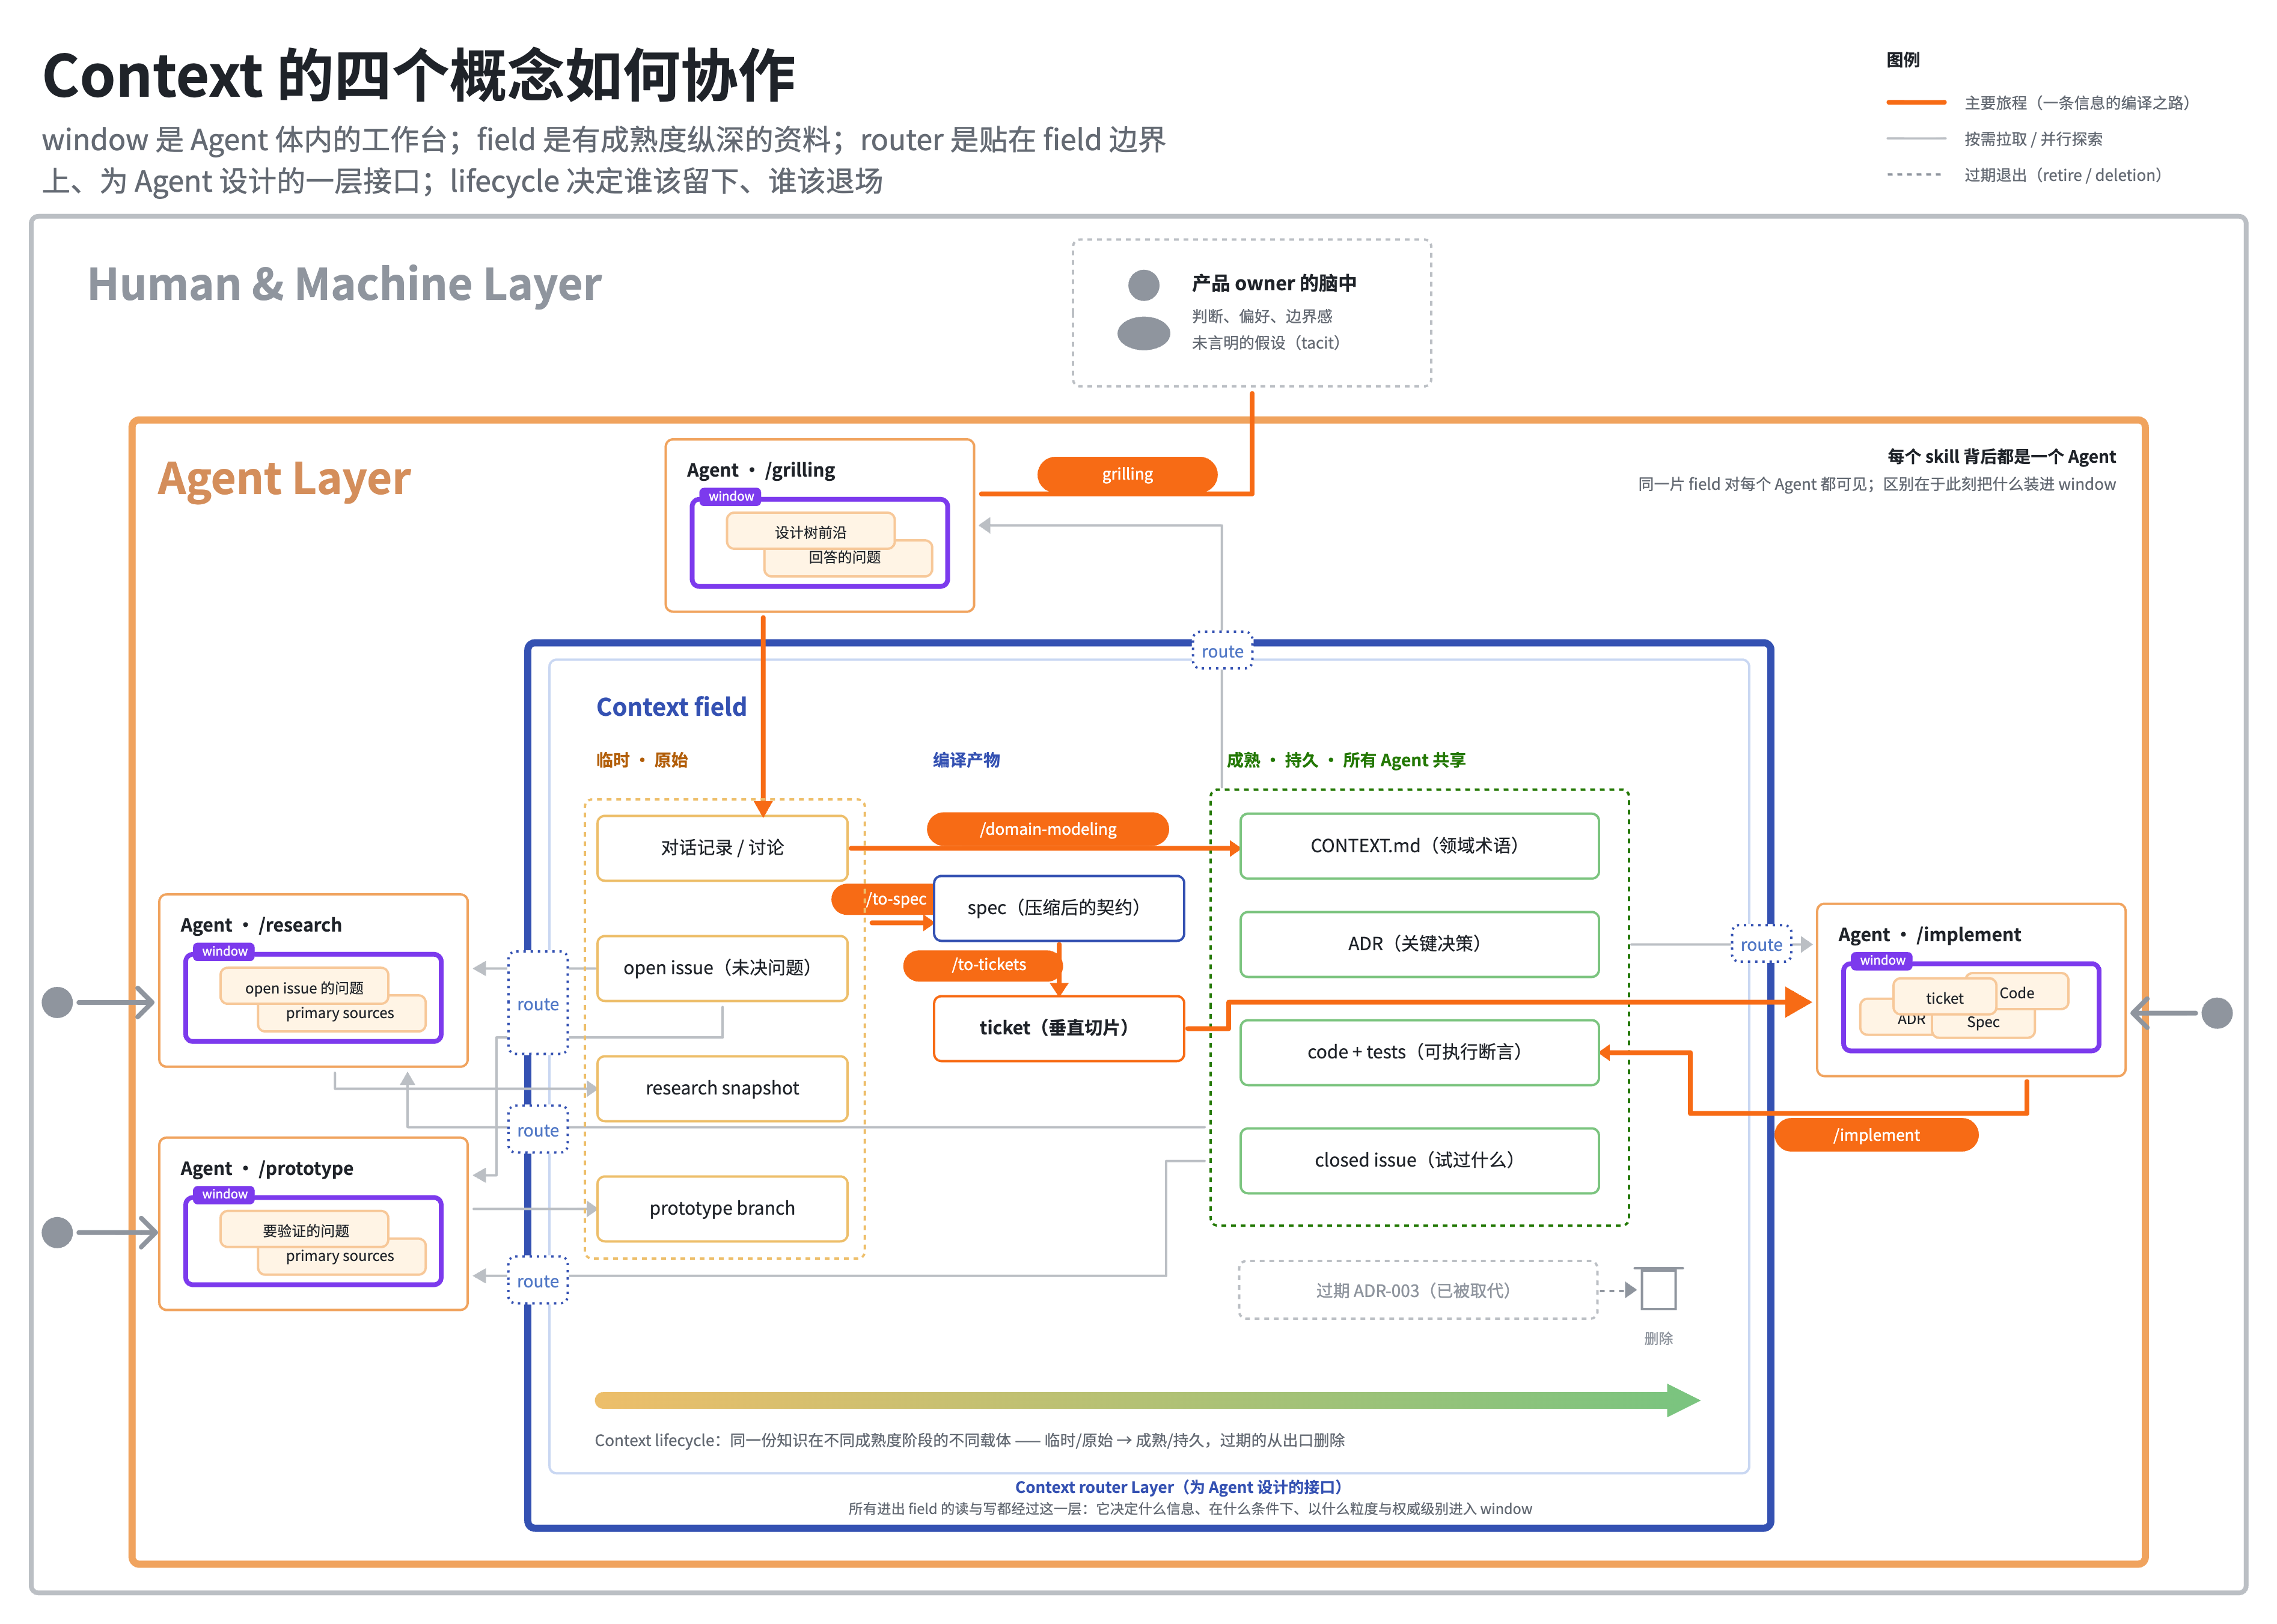
Context field && lifecycle
field 里不同的 context 有什么区别:
地位不同,地位更高的 context 更可信
类型不同,不同类型的 context 重要程度不一样,受到的关注也不一样
是否经过降维&&压缩,经过降维、压缩的 context 用到的 window 更小,更利于 Agent 使用
时效不同,某些 context 应该具有过期时间。
而 context lifecycle 就是一条 context 在地位上移动的路径。没有人能评审一堆 raw material
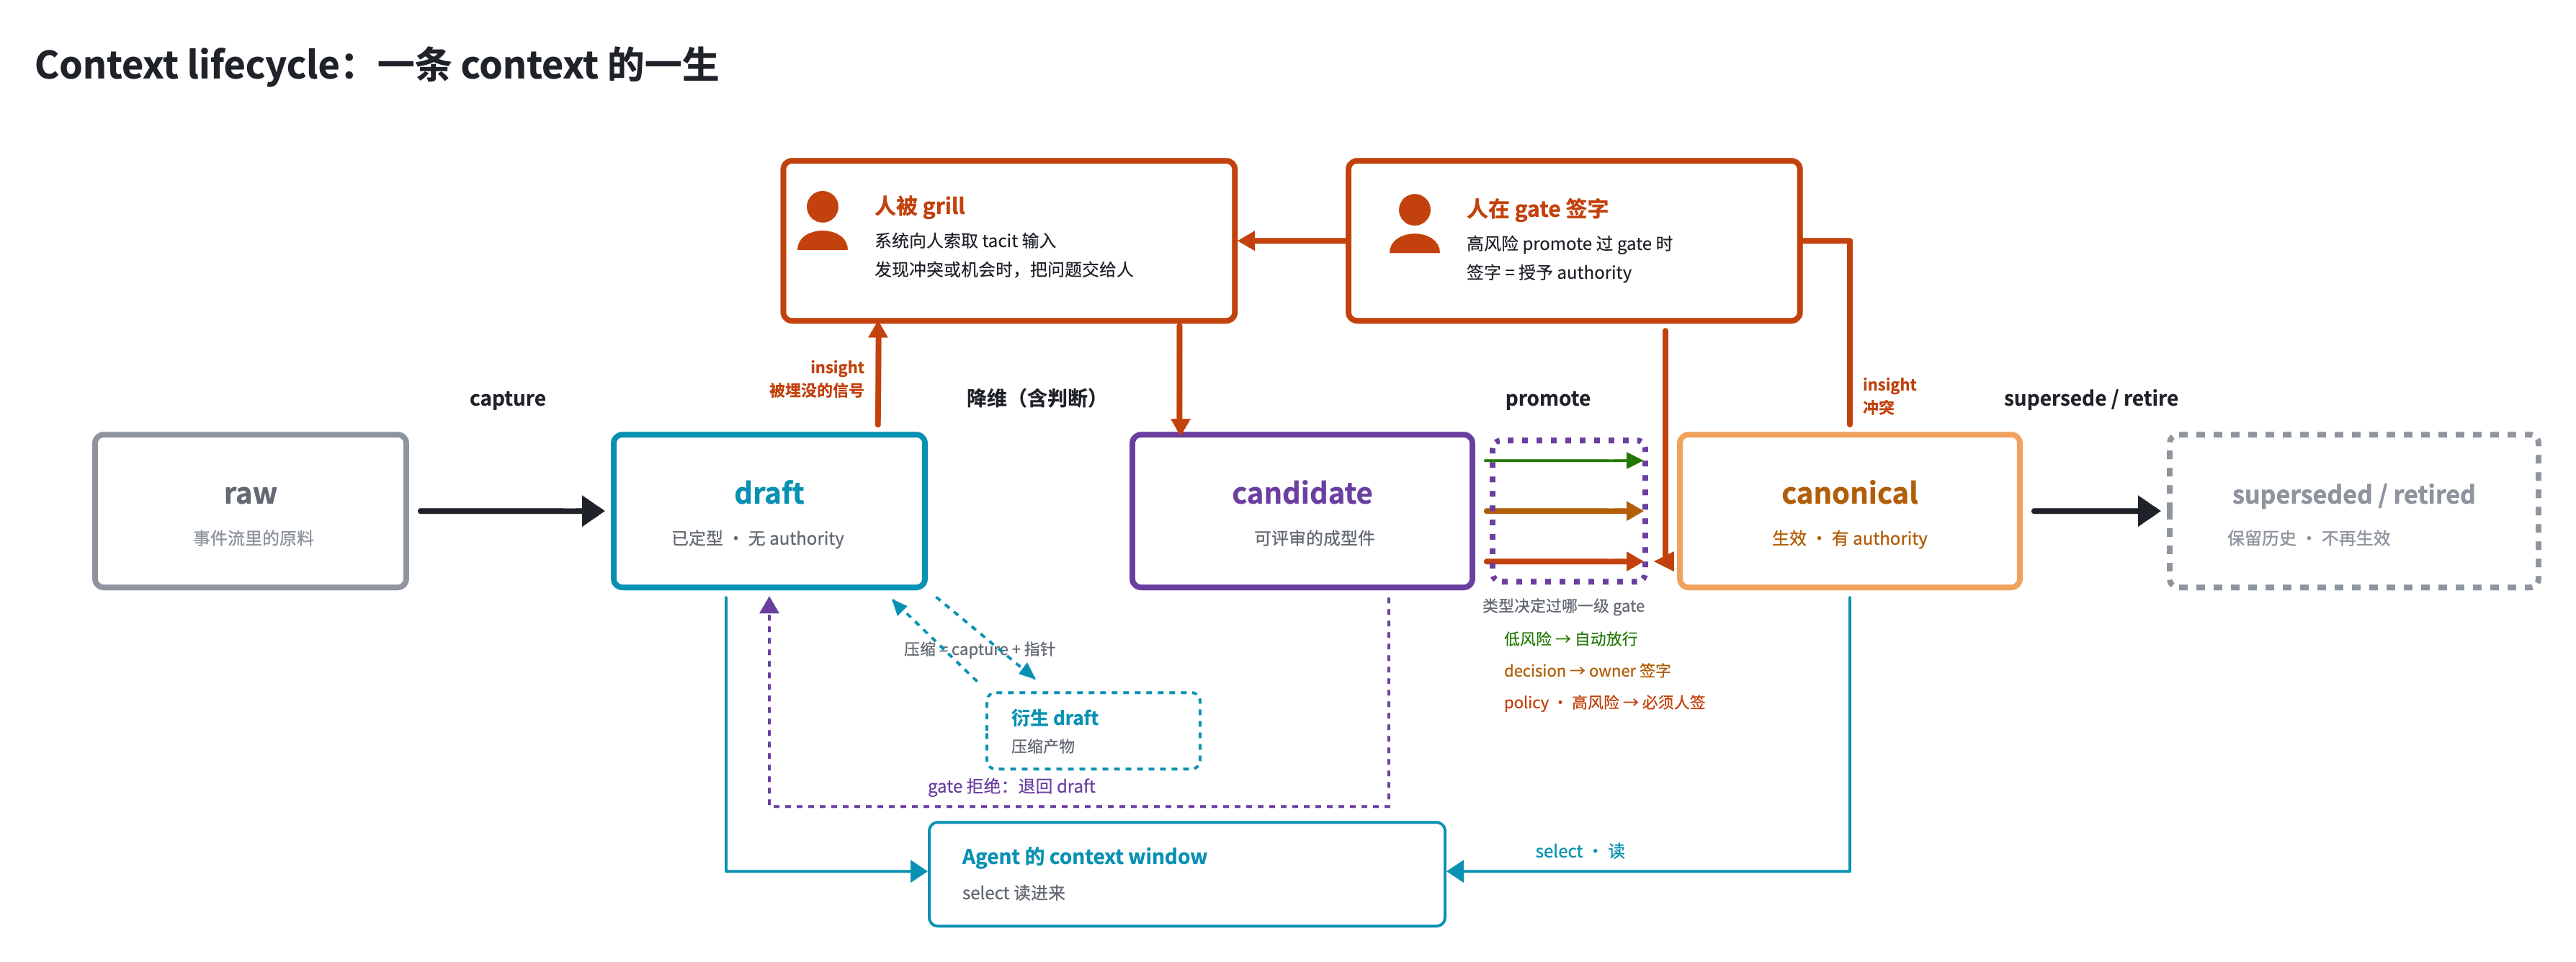
What do we need
Definition
这套东西到底如何抽象,到底给出一个怎样的命名和定义,我想了很久。AI 给出的都是 Context Stack、Context OS、Context System 这种,从语义上确实能概括(毕竟包含了所有),但又总感觉少了点什么。
一开始确实是一团乱麻的,我首先从这套系统的使用者上作了区分:
系统外
人类可以直接地看到代码、CONTEXT.md、ADR、issues,也可以在这些东西上直接进行修改。但是当人类当前世代真的开始使用这套系统的时候,他在大多数时候,都不应该直接去看。他应该是在与 Agent 协作的时候,Agent 去读取这些 Context field。所以人类直接对接的是 Agent
Agent 主要是通过 Context router 按需获取 Context field
系统内
人类需要 grilling 把自己脑子里未明的假设和 Agent 说清楚;另外需要对 Context field 压缩的结论做 promote,并且需要对此负责
Agent 会在系统内充当各种 worker,让 Context field 能够更加自动化地沿着 Context lifecycle 对 Context 进行压缩和降维。
所以这个系统要面临的一些挑战就可以抽象出来了:
如何让 Agent 准确地索引到必要的 Context field,也就是读取数据的问题
如何让 Agent 在系统内合理地进行压缩
如何让人类适时地介入
grilling和promote,即输入必要的上下文,以辅助 Agent 能做出正确地判断。判断的过程可以理解为处理冲突
promote 则是在 Context 经过压缩之后,做出的二次确认,判断它是否需要被持久化,持久化后的 Context field 则具有更高的权威性(地位)以及更高的被检索频率。暂且把它称为两阶段确认
这些问题让我突然联想到了 Database,这其实就非常类似于 Database 要解决的问题。所以我想把这个系统称为 ContextBase。
果不其然,我不是第一个想到它的。https://www\.appliedcompute\.com/research/remember\-refine\-retrieve 这篇文章已经提到他们在做一个这样的系统。
原语
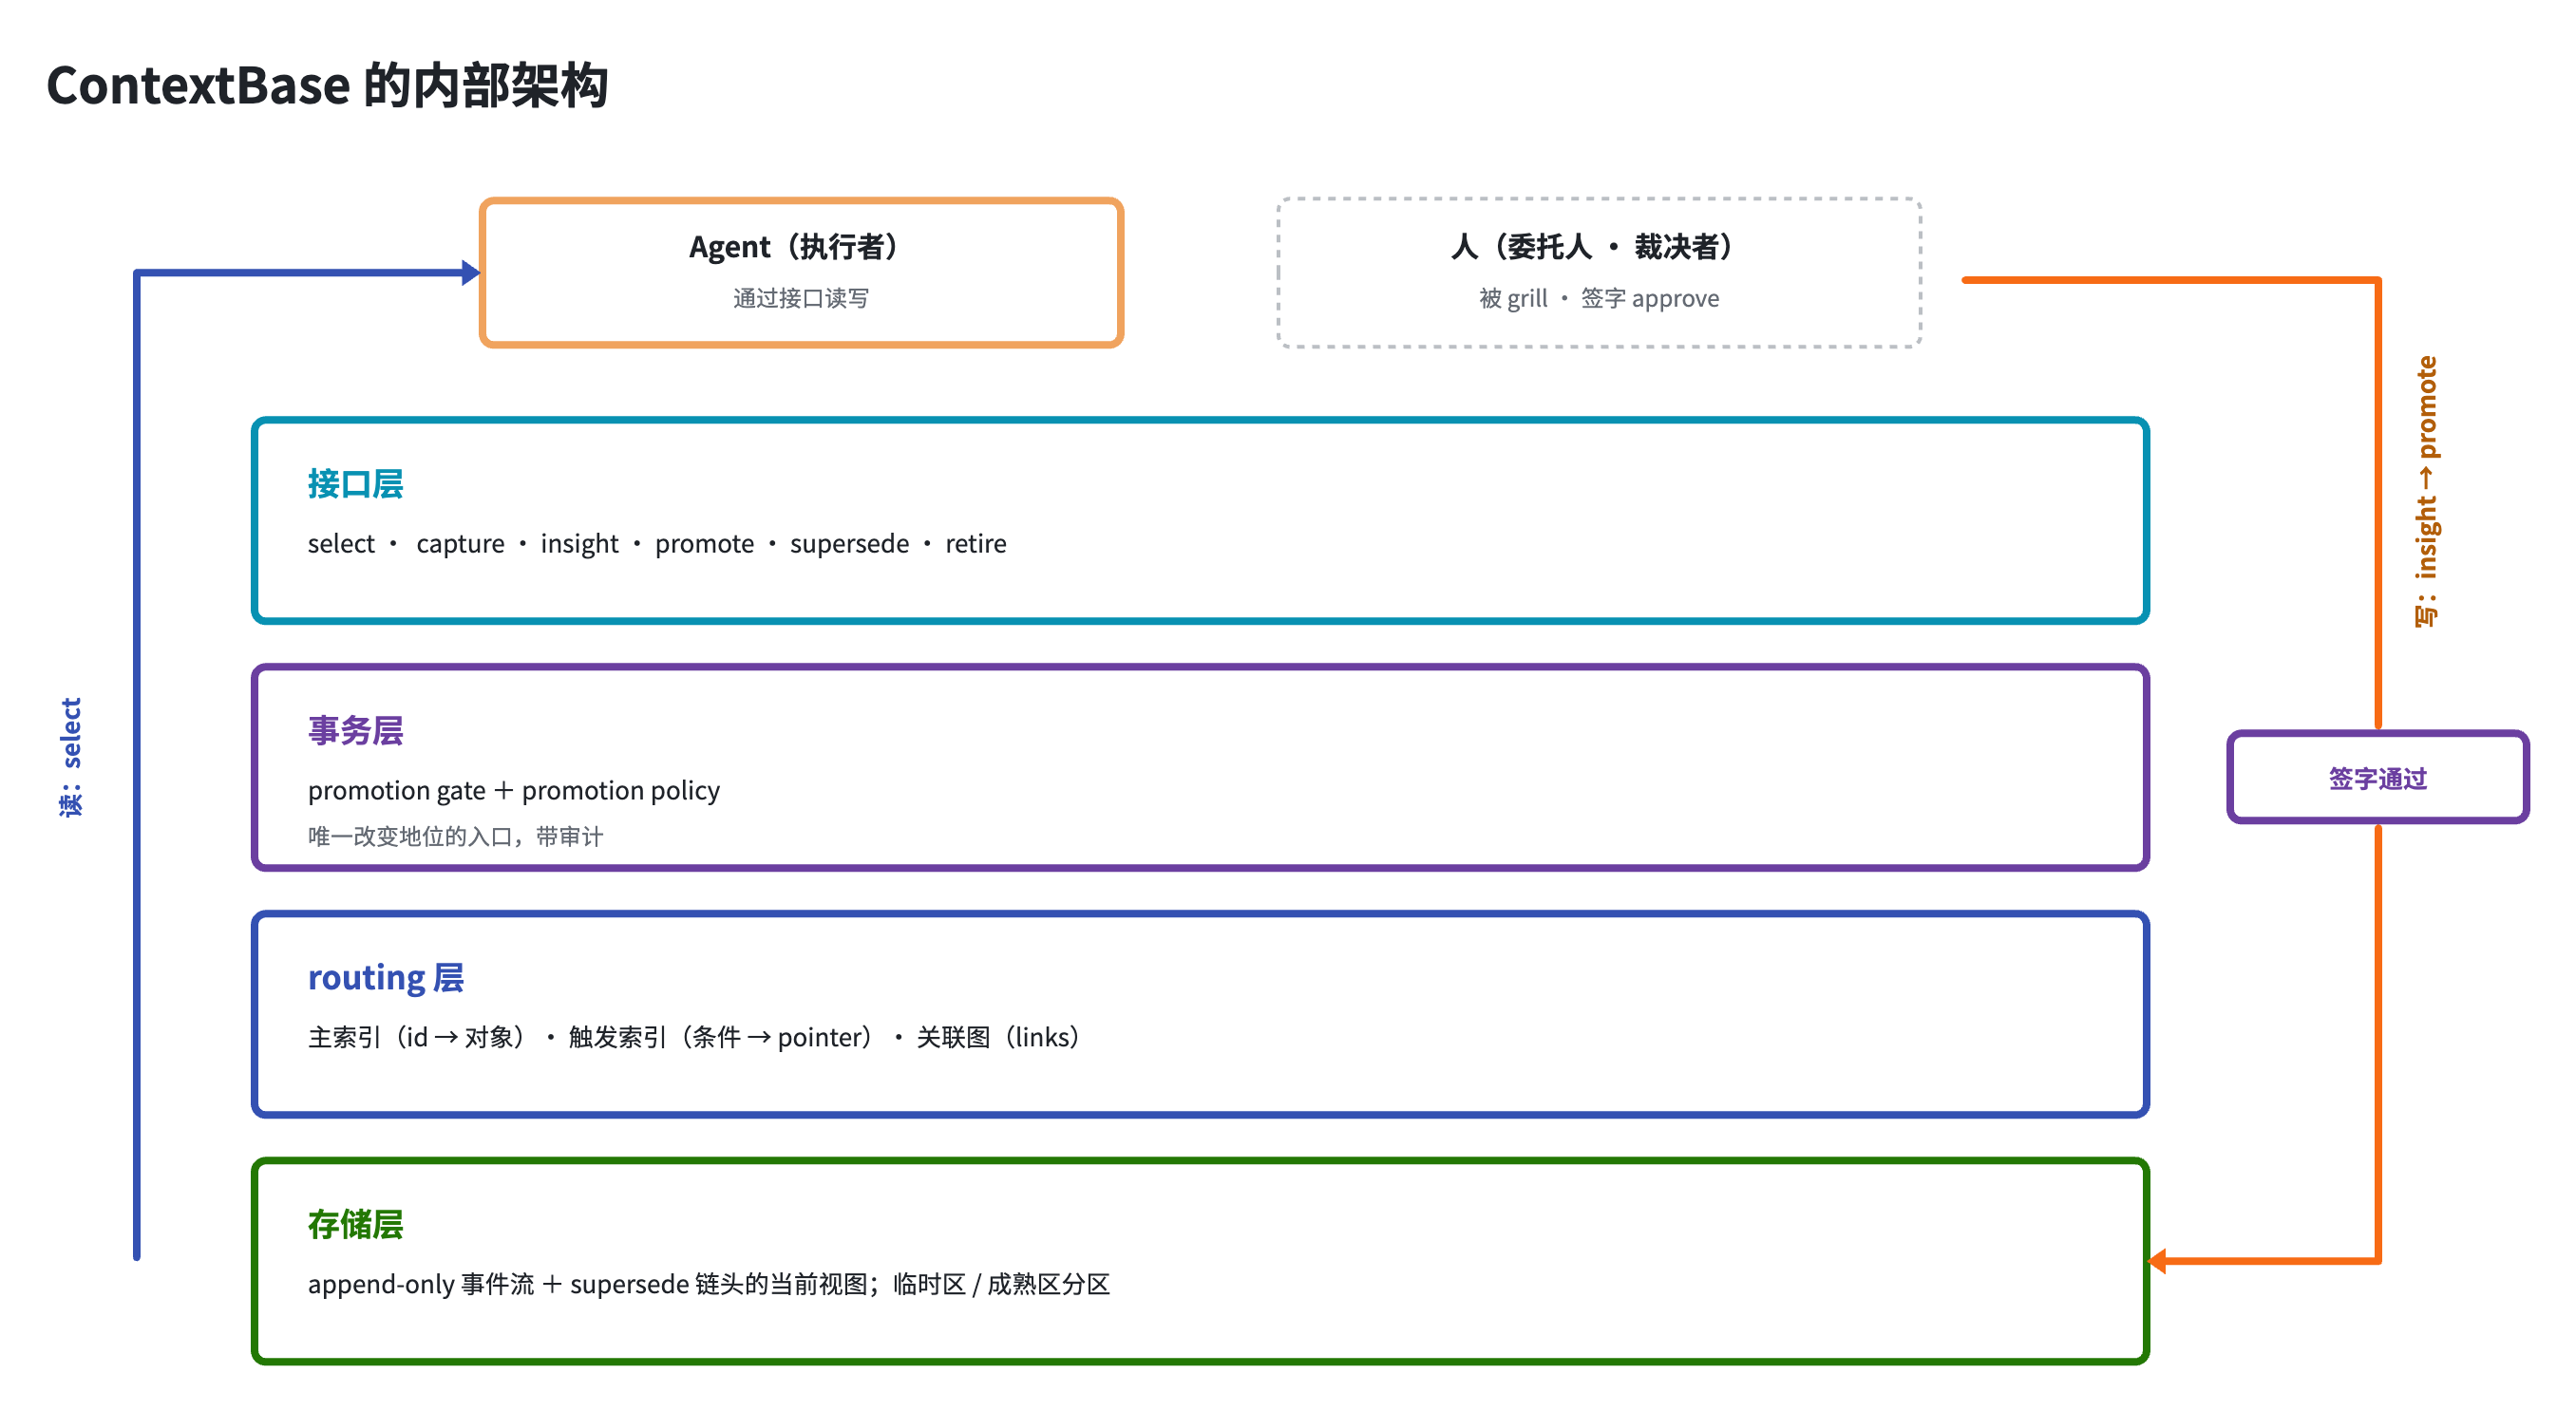
对应于 database 的 insert / select / update / delete 操作,ContextBase 的原语是:
读(任何 agent 在权限内都能做):
select(what, authority) → agent
写(Context 地位的变迁):
capture(content, evidence) → draftinsight(context) → human → candidatepromote(candidate) → canonicalsupersede(old → new)/retire(address)
Context infrastructure
这些 context 就只存在于个人工作中吗?它们难道不是无所不在吗?为什么只是在个人工作中用起来这么顺手呢?特别是在代码开发领域用起来是最丝滑的呢?
我们简单地把 context 从 codebase 往外推:一个公司、一个团队、一个项目、一段关系这些都是一个 contest system
就拿组织来说吧,组织真正的 context 往往没有存在正式文档里。它藏在:
这个事平时要找谁;
哪些例外是约定俗成的;
某个流程为什么长成现在这样;
某个客户过去发生过什么;
某份合同真正影响哪些业务动作。
Aaron Levie 在谈 enterprise agent 时提到:codebase 开发拥有代码、spec、文档、version control 等高结构化 artifacts;企业其他知识工作里的 context 则散落在会议、权限系统、SaaS、口头沟通和不同格式的数据里。软件开发不自觉地建设了全人类知识工作中最完善的一套 Context Infrastructure。Git、commits、diffs、issues、tests、types、compiler errors、CI、specs、ADRs…… 这些东西在上一个时代叫「软件工程实践」。进入 agent 时代后,它们变成了 Context Infrastructure。Git 的 object store 是它的存储,merge 和 review 是它的事务,AGENTS.md 和路径约定是它的 router。Matt 的 skills,是在这个 ContextBase 上跑起来的一组面向 Agent 和人的应用。
如果脱离代码仓库,把目光投向更广阔的组织和知识工作,就会发现,企业真正依赖的其实是 human context infrastructure。
一个优秀的 manager 或 team lead,大量的工作其实是:参加多个会议,从各处收集信息,理解不同人的隐含背景,压缩成一段能被别人理解的话,告诉团队过去已经决定了什么,解决冲突后再把结论传播回去。也就是说,他们实际上充当了组织里的人工 cache、router、compressor 和 authority resolver。其实不止是 manager,普通员工也或多或少是某些 context 的 cache/router/compressor。
如果我们将 ContextBase 的思想引入组织,那么管理者和员工可以少做 context courier(上下文搬运工),多做 context governor(上下文治理者)。
一件事需要 manager 批准,不应该意味着 manager 必须手工把所有 background 搬到自己脑子里。假如组织里有一个这样的 ContextBase,我们就可以轻易获取到必要的 background。
组织里的 ContextBase
组织真的需要这样一套东西吗?如果需要,为什么是现在?它会长什么样,组织里的人凭什么会用它?它会把组织、以及组织里的每一种角色变成什么样?以及它真的造得出来吗?
凄惨的现状
在讨论组织形态之前,先停下来回答一个更基础的问题:上面提到的这些东西——Git、commits、diffs、issues、tests、types、compiler errors、CI、specs、ADRs——在组织里到底对应什么?
首先这些全不是为 AI 发明的。 Git 是为了让几千个互不信任的开发者协作;tests 是因为人会犯错;CI 是因为人会忘记跑 tests;ADR 是因为人会离开,而理由不能跟着离开。它们是对人类弱点——遗忘、懒惰、不可靠——的补偿机制。也正因为它们补偿的是“人”的弱点,agent 才意外地继承了一个早已为人类弱点打好补丁的世界。
组织当然也有同样的需求,只不过组织没有用一套固定流程来解决,而是用人肉与机制来代偿:
| 软件世界 | 在解决什么问题 | 组织 |
|---|---|---|
| Git / repo | 当前事实需要唯一、可寻址、带完整历史的家 | 制度汇编 + 档案室 + 聊天记录 + 几个老员工的大脑;没有 main branch,人人手里一个互不同步的 fork |
| commit | 状态变更应是带作者、时间与 message 的原子事务 | 会议上的一句 “那就这么定了”,微信里的一个 “👌”;大多数决定从未被 commit |
| diff | 精确回答 “到底变了什么” | 新版制度 PDF 群发,差异自己找;或者根本没人发现变了 |
| issue | 开放问题需要可寻址的容器,带状态与 owner | “这事还没定” 活在某人脑子里;跨部门悬案没有 tracker |
| tests | 把 “我们相信世界应当如此” 写成可执行断言 | 出事之后的复盘;政策是否被遵守靠抽查 |
| compiler errors | 在代价最低的时刻(行动前)给出精确反馈 | 老员工拍肩膀:“这个不能答应客户”;或者犯错很久之后的追责 |
| CI | 每次变更后自动跑全套检查,不依赖人记得 | 内审、合规抽查、季度 review—— 低频、抽样、滞后 |
| spec | 把实现契约压缩成低歧义文本 | PRD、SOP,写完即腐化,没人维护 |
| ADR | 保留 “为什么”,尤其是在结果被遗忘之前 | 几乎不存在。“当初为什么这么定” 随老员工的离职一起蒸发 |
| package manifest | 声明环境由什么构成、依赖什么、如何启动 | 入职大礼包、部门 wiki 首页、“有事找谁” 表格 —— 静态且腐化 |
现存的大部分职能,组织今天都是靠特定的人来完成的。这就是前文所说的 human context infrastructure。有些对应物今天看似存在——wiki 像 repo,制度汇编像 spec,审计像 CI——但形似而神不似。缺的不是文本,而是生命周期与 authority。
为什么是现在
这些需求存在了几十年,为什么一直是人在做,而不是机器?
是因为执行者发生了变化。软件世界之所以构建了 Context Infra,不是程序员比其他行业更有纪律,而是软件的执行者是机器——代码要在一台不懂暗示、没有默契、不记得昨天发生了什么的机器上运行,于是 context 从第一天起就必须机器可读。而组织的执行者一直只有人:人有默契、有记忆、能读空气,所以组织的 context 可以一直 tacit(默许)下去。
Agent 是进入组织的第一个机器执行者。 它比编译器聪明得多,但它和编译器一样:不懂暗示,没有默契,不记得昨天。组织的 context 第一次拥有了一个必须机器可读才能工作的消费者。当组织开始邀请 Agent 进入时,要为他们准备一个拎包入住的环境。
组织的 ContextBase 长什么样
先来个定义:未来的公司,是一台持续把事件流编译成 Situation 的机器——而它的底座,是一套组织级的 ContextBase。可以从三个角度看它:怎么分层(结构)、归谁所有(治理)、怎么被消费(界面)。
怎么分层:
存储层:会议记录、IM 记录、CRM、审批流、文档等
routing 层:SOP 里的 trigger、带条件的 pointer
事务层:即审批流;
接口层:面向 Agent
归谁所有:Domain-owned Context
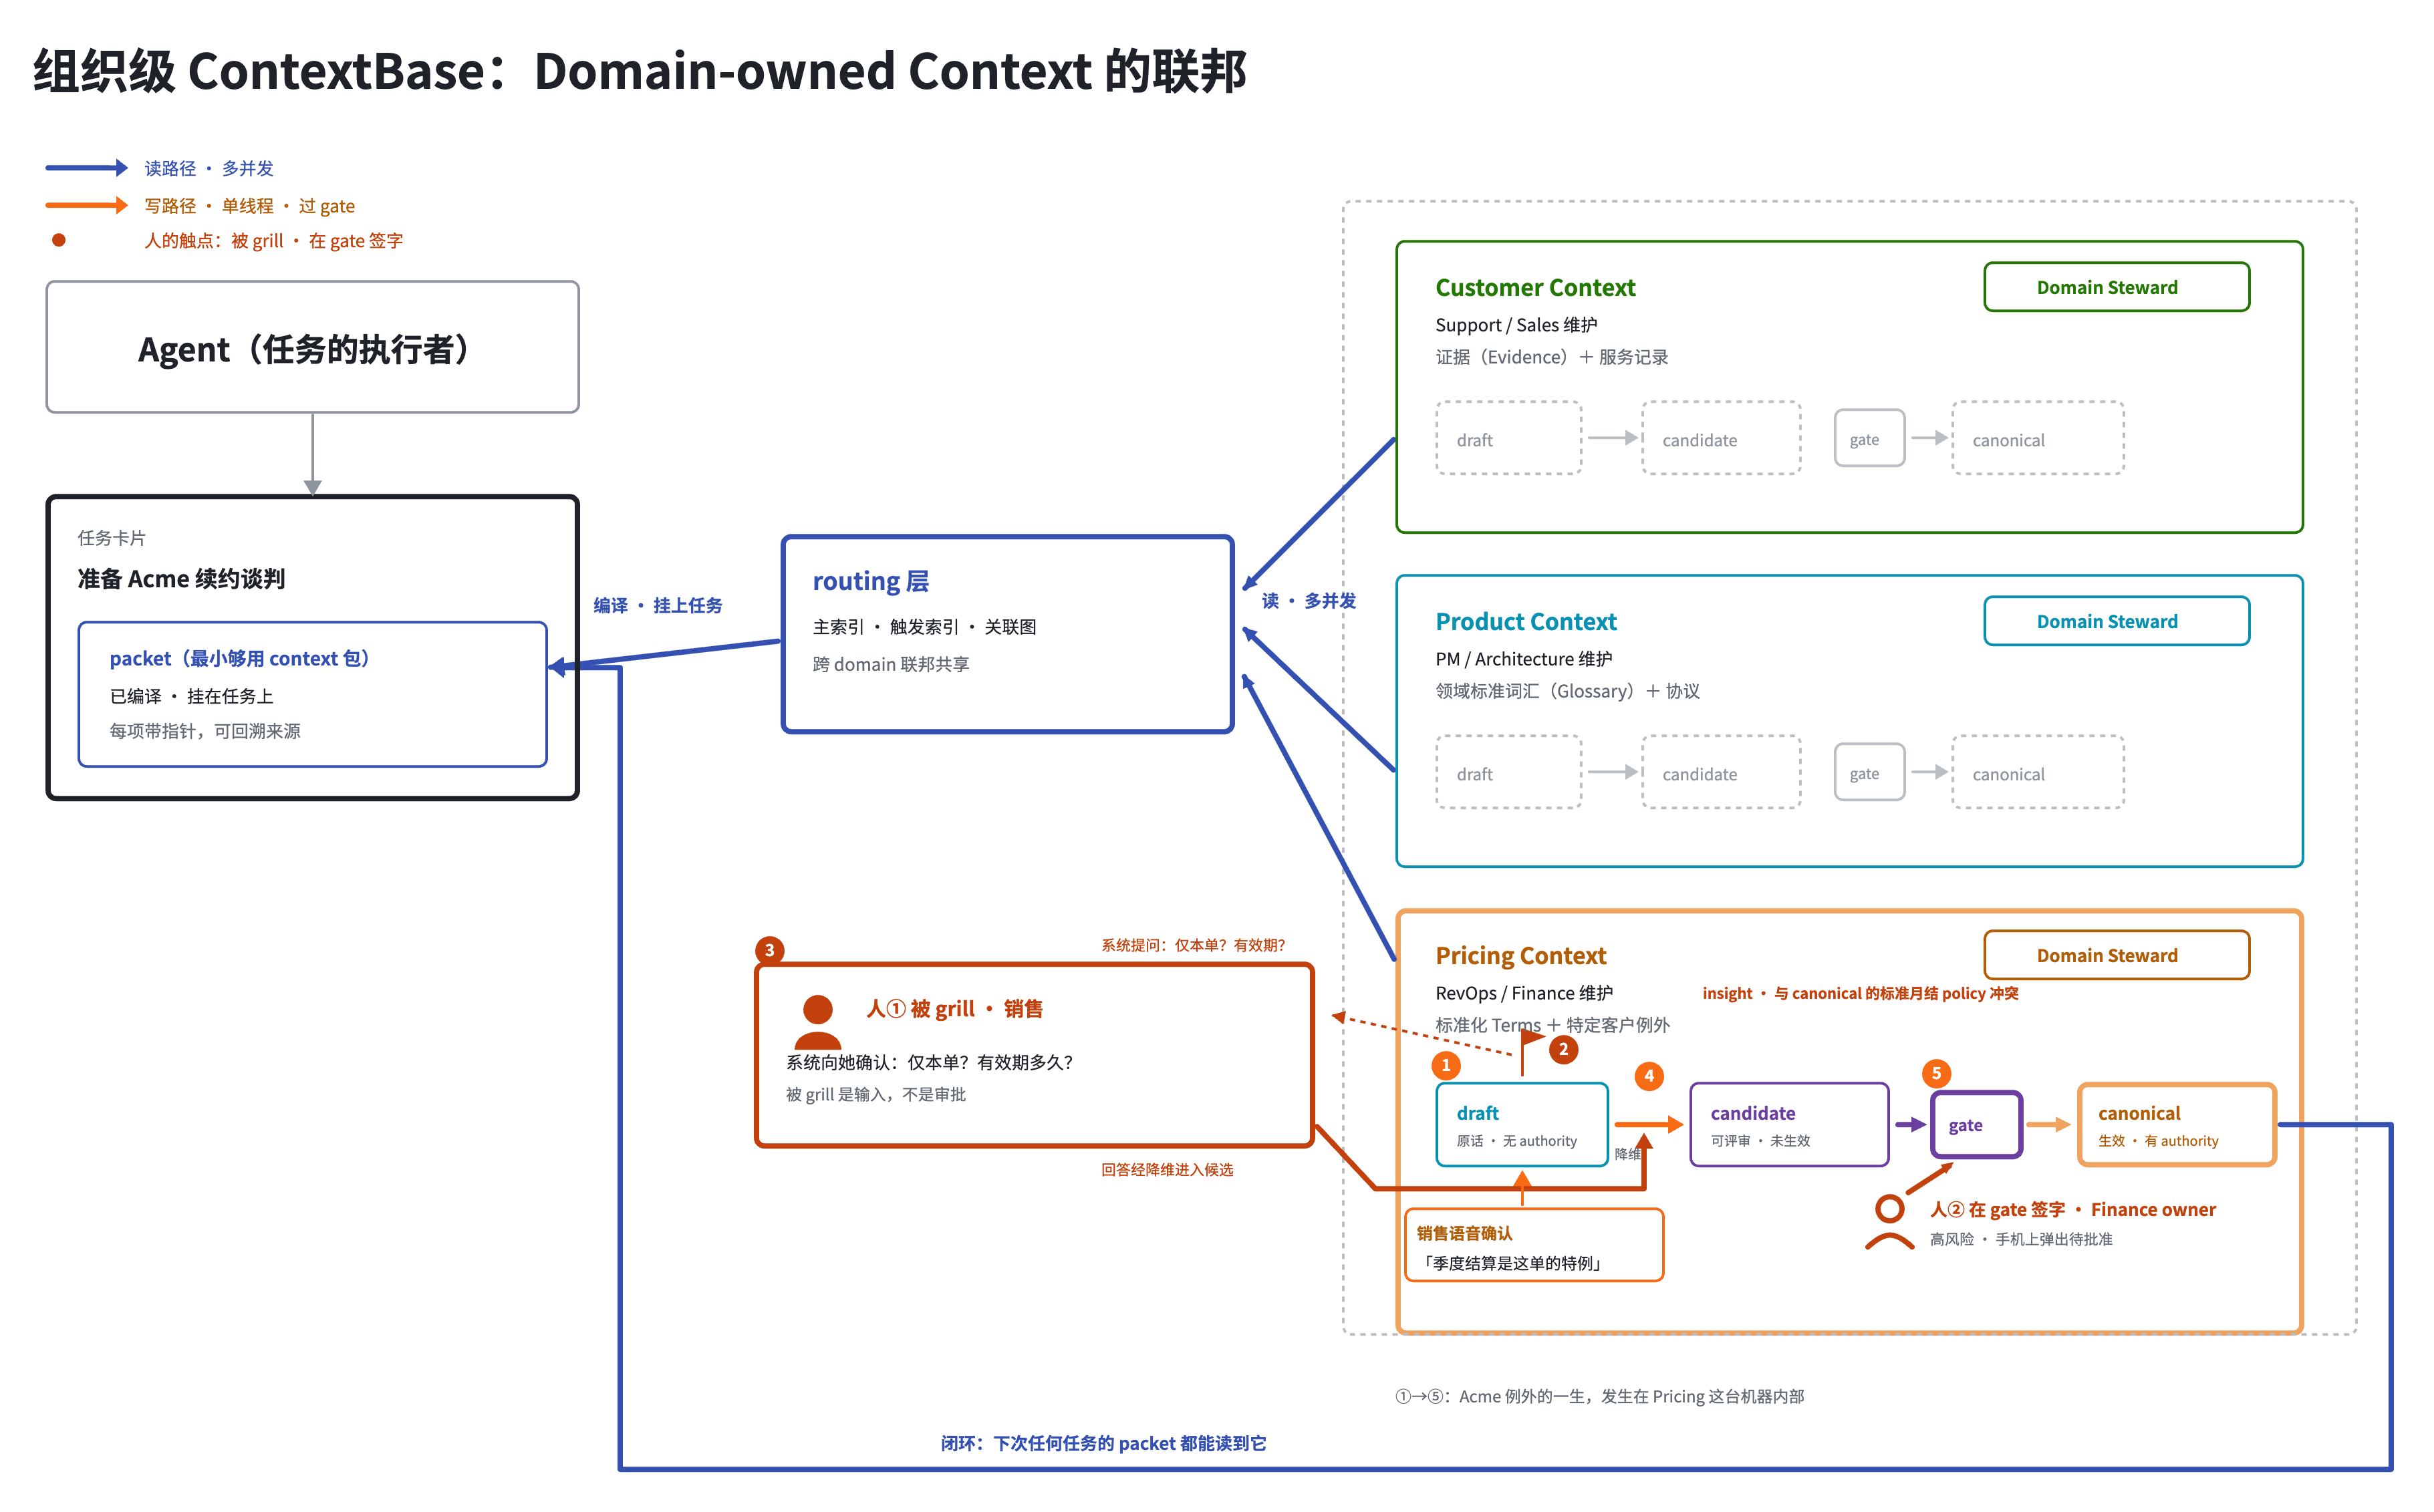
借鉴 Data Mesh 的思想,未来的企业不再建立 centralized 的中央知识库,而是转为 Domain-owned Context:
Pricing Context 由 RevOps/Finance 部门维护,包含标准化 Terms 与特定客户例外;
Product Context 由 PM/Architecture 团队维护,定义领域标准词汇(Glossary)与协议;
Customer Context 由 Support/Sales 维护,捕获证据(Evidence)与服务记录。
以及更多的 Context 类别和部门
每个 Domain 团队像维护 API 一样维护自己的 Context Product,负责其正确性、有效期限与 Promotion。
怎么被消费:基于 Situation 的工作方式
跨部门的巨型复杂工作(如大客户续约、产品 launch、监管整改)不再依赖长篇大论的 Status Report。
团队将使用类似 Wayfinder Map 的 Situation Map 来表达当前状态:
Destination:我们要达成的终点;
Accepted** **Context:已经确定的条件与政策;
Uncertainties / Open Tickets:当前阻碍 progress 的未决问题;
Out of Scope:明确不讨论的内容。
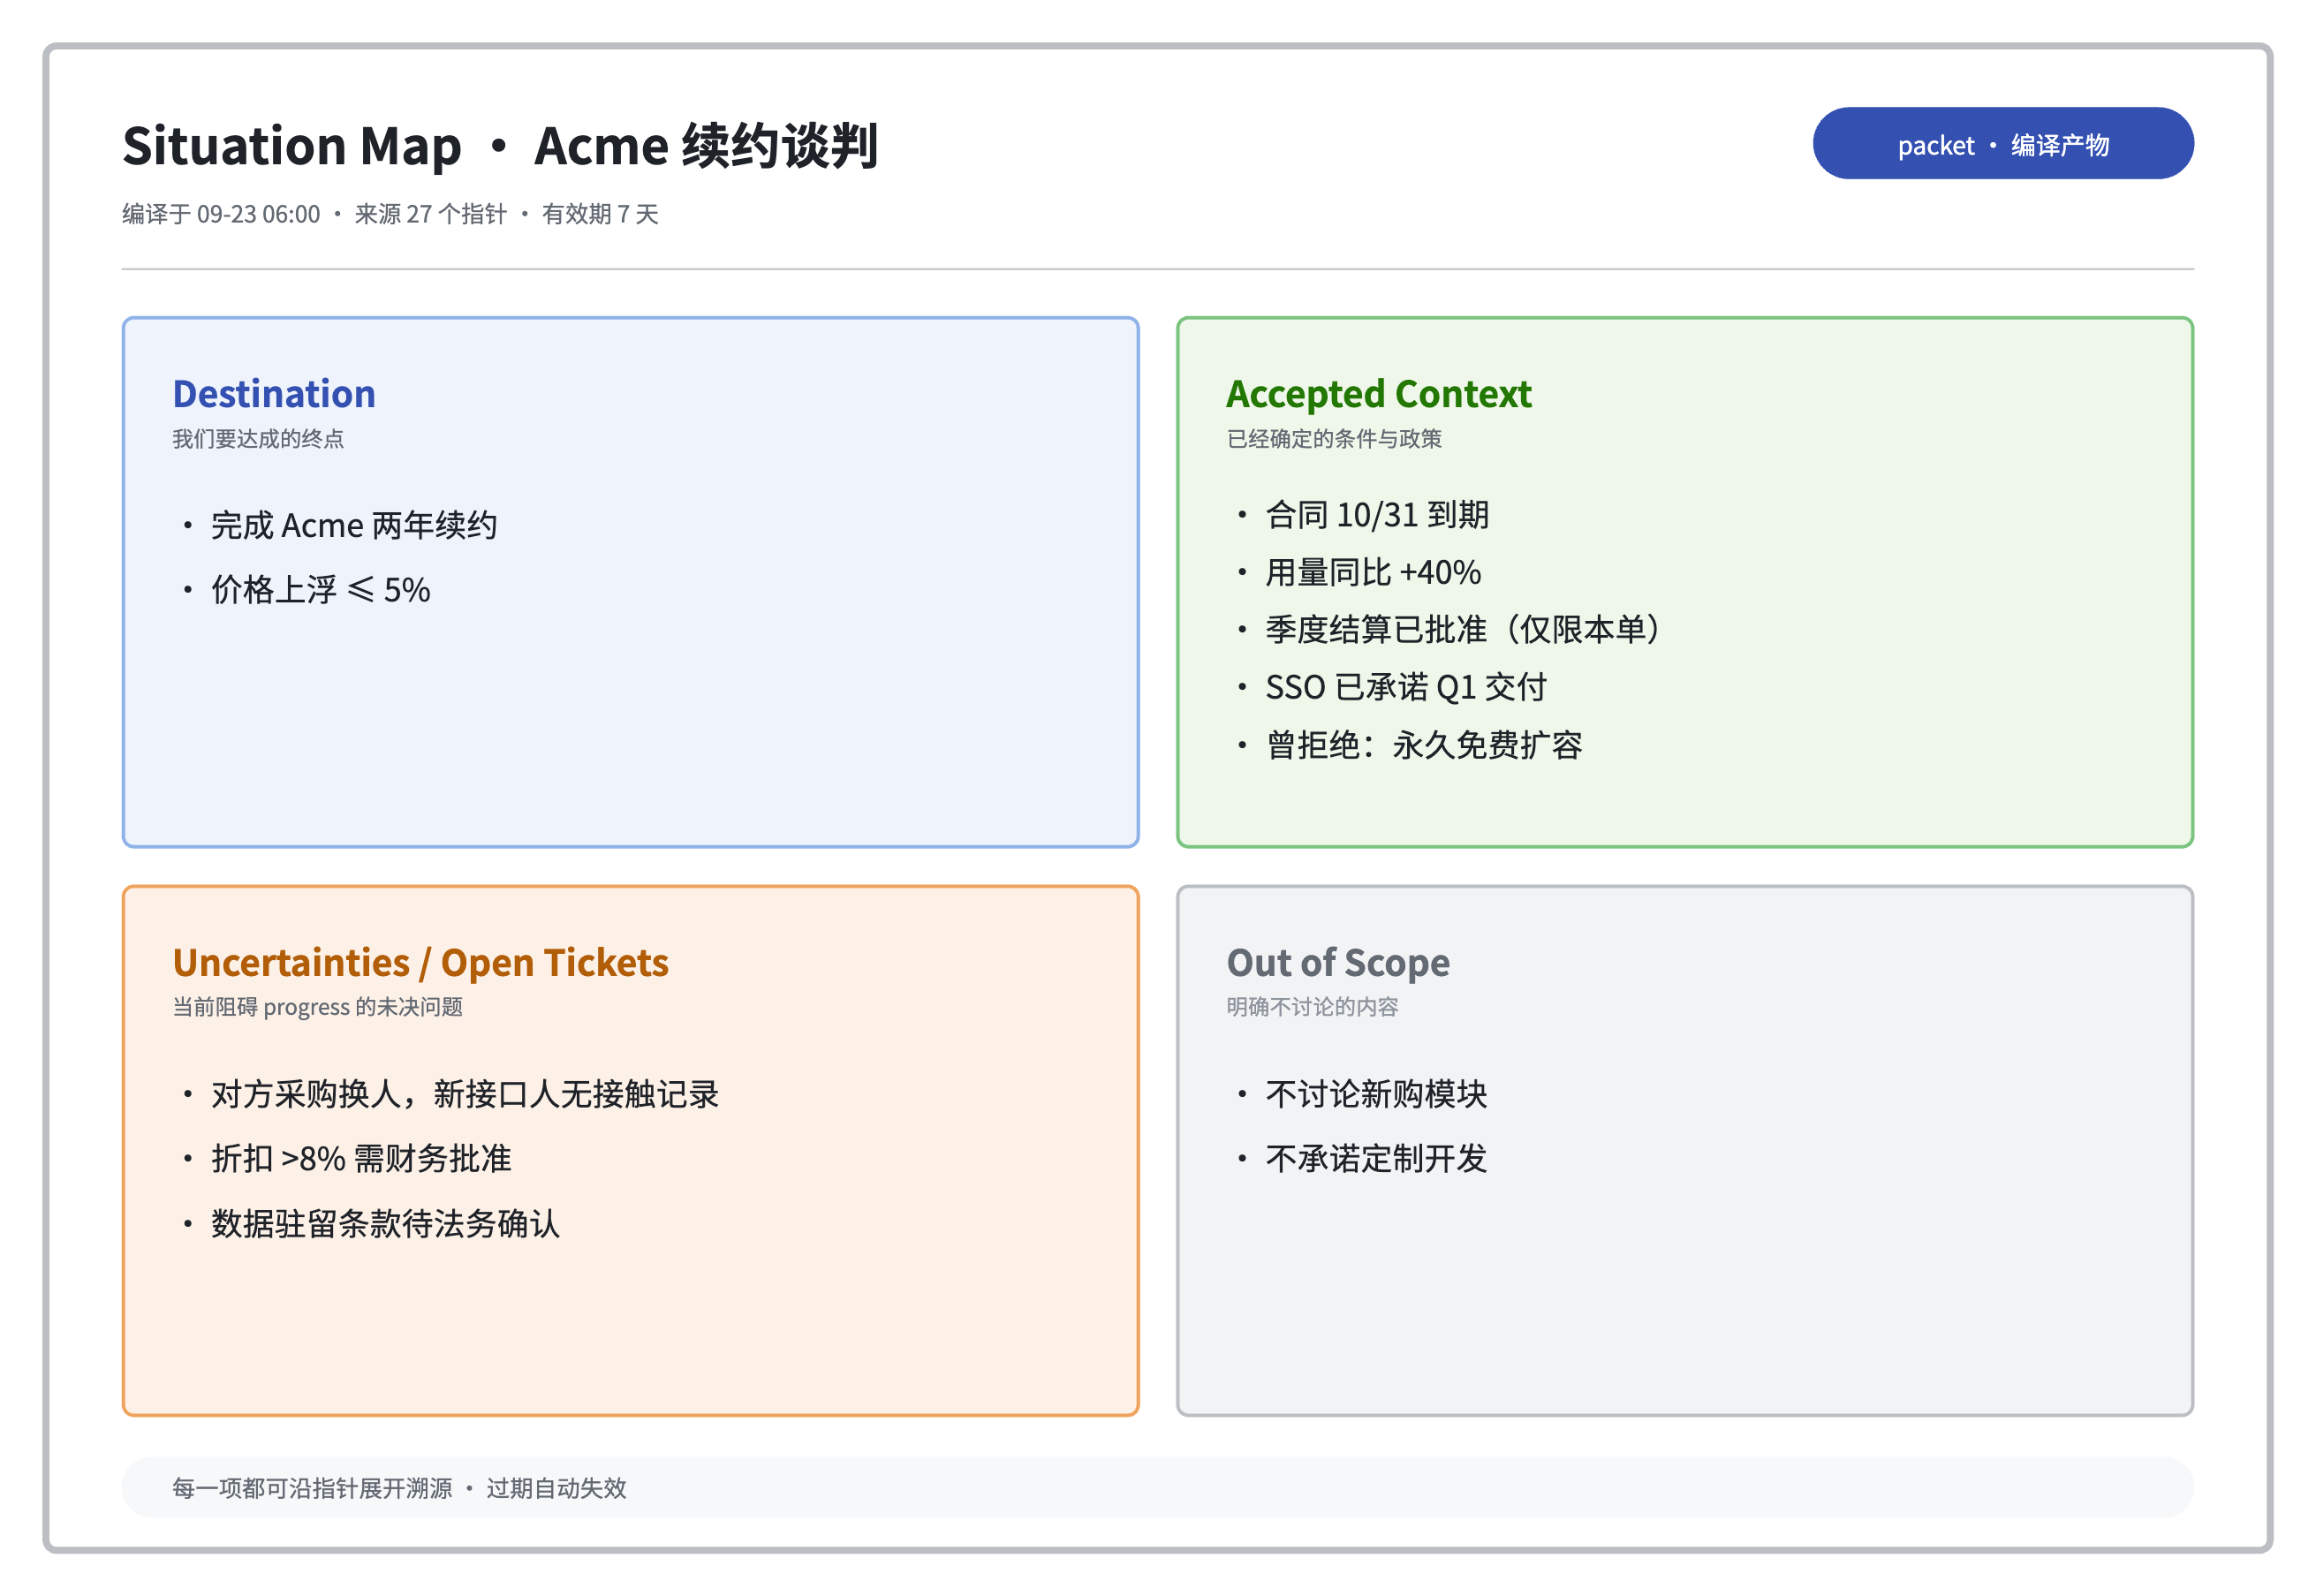
每一个 Agent 或新加入的人员,只需读取这份 Situation Map,就能在短时间内恢复对世界的正确认知,并独立领走一个明确边界的 Ticket 展开工作。这就是 situate 的组织形态。
人是懒惰的
Wiki 坟场、无人问津的知识库、永远停在第一页的 onboarding 文档——它们存在的原因都是:把维护成本放在自己身上,把收益放在未来和别人身上。 理性而懒惰的个体做出了完全正确的选择:不维护。
所以人只会对 ContextBase 做两个交互:
被 grill。系统向人索取 tacit 输入
在 gate 签字。人向系统授予 authority
所以 ContextBase 的首条设计理念其实是个行为学问题:任何依赖人主动维护 context 的设计都会失败。这可以展开成四条交互原则:
采集是工作的副产品,不是第二份工作
只在值得的时刻向人索取注意力
Context 来找人,而不是人找 context
纠偏即维护
组织、角色与权力的迁移
假设组织级的 ContextBase 真的建成了。它对组织、对组织里的每个人,意味着什么?
对组织整体
大量协调机制的存在理由消失了。周报被编译出来的 situation map 替代;对齐会被 glossary 与 canonical context 替代;层层汇报失去了 routing 功能
组织获得了“可克隆性”:任何一个新成员,无论人还是 agent,都能迅速恢复对处境的正确理解。组织不再惧怕离职、轮岗和快速扩张。
组织的边界开始松动。科斯说,企业的边界由协调成本决定:内部协调比市场便宜的事,才值得放进企业内部。当“让一个新成员恢复处境”的成本趋近于零,内部与外部的协调成本被同时压低。未来的组织可能会是一个稳定内核加一圈高流动性的外围,而不是一座围墙。
对中层管理者
管理工作里很大一部分——找资料、收集状态、重复解释历史、搬运会议结论、手工写周报——会被最先自动化,这部分工作消失就是消失了,不会换个形式回来。剩下的是判断:目标是什么、谁拥有决定权、冲突时牺牲什么、哪个风险值得承担。
管理从一种“信息职业”变回一种“判断职业”,靠信息差生存的管理者会被暴露,靠判断力生存的管理者会被解放。
对那些充当人肉基础设施的老员工。几十年来,他们的权力和安全感来自“只有我知道”。未来这份资产会充公:对组织是解放,对个人是剥夺。Domain Steward(领域知识管理员)是一条出路:从“垄断记忆的人”变成“治理记忆的人”。
对高管,战略变成可编译的同时,也变得可追责。 Provenance 是双刃剑:功劳有据可查,锅也是。“集体决策”“会上定的”这类免责迷雾消散了。对敢于决策、敢担责的人是利好,对靠模糊生存的人是末日。
还会有一些新的角色:Domain Steward 负责一个领域的认知质量,Context Platform Team 负责这台机器本身,而跨 domain 的语义冲突,需要一种联邦式治理(Federated Governance)来裁决。
ContextBase 不会消灭组织的政治、惰性和愚蠢,它会把这些东西从暗处请到明处。
随笔
正文写完了,接下来是我个人对 memory 和 multi-agent 的理解和感受。全是主观性。
Memory 产品
我觉得通用的 Memory 产品在当前很难有实质性的突破。
我认为 Memory 可以分为生活和工作两块,这两块各自覆盖了非常多的场景。但如果把它们混在一起,这种 Agent 或 Memory 产品在当前情况下很难做出来。
工作需要的上下文实在太多,而且它和日常生活高度独立,没有特别大的关联。工作细节、具体实施、工作流程等 Memory,对日常生活基本没有影响。只有工作最顶层的 context 才和生活相关,比如你在哪家公司、哪个地点上班,上下班时间、加班频率、出差频率,或者能否提前下班接孩子等。这些能与日常生活产生关联的 Memory,其实可以归到生活这一类。
除此之外,具体怎么工作、工作内容是什么、上下级是谁、上下级之间的性格、如何协作、各自负责什么,这些与生活隔得很远,底层逻辑也完全不同。所以在当前情况下,把生活和工作的 Memory 分开,是更好的选择。工作上的 Memory,本质上是组织 context 的问题,也是多 Agent 协作面临的问题。
先回过头来看生活上的 Memory。它相当于一个人的记忆外挂,帮我们多提供一个存储记忆的地方。
生活记忆的获取途径与类别可以这样划分:
社交媒体与生活类 IM(如微信、Telegram、QQ 等):它们包含了我们大量的生活线上语料和资源,最能代表一个人经历过的 Memory。
录音设备(如录音笔):用来记录日常生活中遇到的事。我们看到、听到、说过的都算记忆,而语音信息非常丰富,处理门槛也相对视觉信息来说较低,很适合用来提取出更完整的个人全貌。
电子设备的使用轨迹(手机、电脑、iPad):所有 APP 和网页的使用轨迹组成了一个人的生活
在具体实现上,很多生活维度需要做抽象,我认为比较重要的是:
人际关系(Relationship):这是生活中极其重要的一部分。人是社交动物,是一切社交关系的总和。
个人画像:从语音或社交媒体物料中提取出个人的性格、说话方式等特征。
生活 Memory 一个非常重要的应用方向是提供 Insight,这能衍生出很多好玩的场景。比如 Relationship Insight:
察觉人际关系中的裂痕,或是发现潜在的发展对象、爱情与挚友。
感知身边的信号:挚友遇到了什么困难、需要什么帮助,他们正在释放什么信号。
自我关怀:通过你的语言察觉你是否在某一时刻变得脆弱或焦虑。
此时,Agent 就能从这些 Insight 中发掘出有价值的信息,为自己提供支持与帮助,这是非常有趣的方向。
多 Agent 协作
我认为多 Agent 协作的实质就是 context 的管理。一个 Agent 与另一个 Agent 对话的质量,会直接影响最终的协作成果。我们在人机对话的过程中,经历了半年到一年的实践,积累了很多 prompt 和 context 管理的经验,但 Agent 本身暂时还没有习得这些能力(未来可能会解决)。在现阶段,Agent 发送对话时不会针对 Agent 的行为模式去思考并调整沟通方式,这非常容易导致上下文污染、上下文漂移等问题。
因此在当前阶段,人的定位至关重要。一个多 Agent 协作平台的定位核心在于:人处于什么样的位置?比如 Agent 如何向人类汇报、如何进行任务拆分等。
拿 Raft 举例,每个 Agent 有自己的 workspace,可以上传文件;其他 Agent 只要知道该 workspace,就能查看里面的文件和文档。但问题在于,这类平台虽然把 Agent 当作人,但 Agent 实际上做不到像人一样:
它在对话交互时,无法像人一样根据 prompt 的优缺点去审慎组织和发送消息。
它缺乏针对多 Agent 协作的明确训练。虽然大模型厂商(像 OpenAI、Anthropic)在内部拆分 subagent 这类内化行为上有过大量训练、实验和测试,能保证一定质量,但并没有针对 Agent 与 Agent 之间的横向协作做过深度的专项训练。
所以目前像 Raft 这种把 Agent 当作人来运作的多 Agent 平台,存在一些很明显的缺点。未来大模型厂商可能会对特定协作任务进行训练来解决这些问题,但现阶段还要再观察。
务实一点来看,我更偏向于不把 Agent 当作人的协作平台。比如我们公司有做一个多 Agent 协作平台,主要是把 Agent 作为 implementer(实现者)来执行任务,里面有一个 workflow 的功能我非常看好。这种模式在现阶段能更好地激发 Agent 的能力,同时也能一定程度上保障产出质量。
但无论是哪一种多 Agent 协作平台的理念,我都觉得组织上的 context(比如 Agent 能访问到的 context 是怎么样的)还是非常重要的。
如果在协作过程中,不同的 Agent 能以一个 root source 来产生决策、修改策略、更新目标和进展,这样会更好一些:比如有一个统一的 progress、统一的 goal;讨论时也能够依赖一些已经确定下来(起码是人确定下来)的根本原则。在这些基础上再进行讨论,也就是所谓的约束。这种基础约束越精准,那么多 Agent 协作产生的结果往往也会更好。
其实就像 Raft 团队也发过的一个视频,在维护、迭代和演进多 Agent 协作产品时,本质上是在想让一个更复杂、更不可控但能力强大的 Agent,能够沿着可行轨道到达预期目标。这其实是在控制诸多变量,在约束的多与少之间权衡操作:约束是让效果更好还是偏离?是限制了它的创造力和能力,还是放大了能力让它发散、却又做出了错误抉择?
这背后的本质问题,可能是 Agent 的能力目前还没有完全具备。但反过来看另一种形态,现在的 Agent 能力其实已经非常强了,只要给予一定约束并进行编排,提高组织效率并没有太大问题。
不过这里面依然会涉及 context 的问题,也就是前面提到的 context space 的理念:
不同的 Agent 之间如何共享 context
context 之间 artifact 的移交与 review
人类在哪个节点进行审批
人类在哪个阶段输入自己的上下文
多 Agent 协作,不如说是多 Agent + 多 Human 的协作的探索
人不会被 Agent “替代”
人是他个人过去所有经历的总和,这些经历不可能被穷举,所以每个人都独一无二,每个人都不会被 Agent 替代,因为 Agent 没办法做到和他一模一样。
思考 Agent 的本质,它其实是一个无状态的执行器,或者说无状态的反馈系统:我们输入什么,它就输出什么,并且必须有输入它才能有输出。现在的 Agent 系统,本质上是利用上了一切它可能用到的 context 去做判断或行动,这其实已经和人非常相似了。但两者的区别在于,输入的 context 永远不可能完全一致,所以输出也永远不可能一模一样。
再来谈谈蒸馏。我觉得技能的蒸馏并不可怕,工作上技能的蒸馏其实是一种必然:它可以被抽象,且可能存在最佳实践,那就应该被蒸馏让 Agent 使用以提高效率。这是生产力与生产关系的升级,必然会发生,因为人性是偷懒的,资本也是逐利的。
如何探索并转型到下一代的组织模型(多人多 Agent 协作)是公司能存活下来的关键,也是人能继续存在于公司的关键。
后记
在写这篇文章的途中,阿里发布了千问办公,这让我很惊讶。
我发现他们的“企业上下文”功能和 ContextBase 其实非常类似。而且让我很惊讶的是,他们甚至发布了一个录音硬件,可以直接对人的录音进行实时处理,甚至不落盘,然后直接发送到企业上下文当中。我觉得这个还是挺牛逼的,他们已经做了一定的实践和落地。
甚至于他们官方微信公众号的标题都和我之前取的一样,叫“Context is all you need”,搞得我很尴尬。
行吧,这次不嘲讽阿里了。希望阿里可以持续地做下去。
 wechat
 alipay